Exploração dos Modelos
Outubro de 2019
1 Criando os datasets de séries temporais
Analisar séries temporais são úteis para verificar padrões e criar previsões de movimentos futuros. Baseado na base de dados alvo de nossa análise, iremos transformá-la em um dataset de série temporal e na sequência criar as bases de treino e teste.
1.1 Carregando a base de dados processada
Carregamos a base de dados alvo, previamente tratada durante os passos explicados na fase de Data Preparation (preparação de dados).
Utilizamos a função customizada GetTimeSeriesDateParameters para gerar todas as datas que serão utilizadas na análise de séries temporais para a base alvo de estudo. Nesta função, passamos o percentual para proporção desejada entre a base de treino e teste.
target_data <- readRDS('../data/processed/target_dataset.rds')
parameters <- GetTimeSeriesDateParameters(target_data$date, 0.70)
print(parameters)
## $start
## [1] 2015 3
##
## $end
## [1] 2019 10
##
## $start_year
## [1] 2015
##
## $end_year
## [1] 2019
##
## $train_start
## [1] 2015 3
##
## $train_end
## [1] 2018 5
##
## $test_start
## [1] 2018 6
##
## $test_end
## [1] 2019 10
##
## $test_sample_size
## [1] 17A função ts vai converter um vetor de valores de uma base de dados em um objeto R de séries temporais. Devemos passar para a função a coluna alvo e os valores de data de início e fim do período de observação bem como sua frequência.
target_ts <- ts(target_data$taxa_venda,
                start = parameters$start,
                end = parameters$end,
                frequency = 12)

summary(target_ts)
## Min. 1st Qu. Median Mean 3rd Qu. Max.
## 4.926 8.469 9.953 10.433 12.633 16.3951.2 Criando o conjunto de dados de treino e teste
Quando vamos criar um modelo de previsão de séries temporais o ideal é separar os dados em duas partes:
- Treino: estes dados serão a base principal para definir os coeficientes/parâmetros do modelo;
- Teste: são dados que serão separados e não foram vistos pelo modelo e serão usados para testá-lo e comparar com as previsões (geralmente comparando os valores passo-a-passo).
O tamanho do conjunto de testes é normalmente cerca de 20% a 30% da amostra total, embora esse percentual dependa do tamanho da amostra que você tenha e também quanto tempo adiante você deseja fazer a previsão. A base de testes deve ser idealmente pelo menos tão grande quanto o horizonte máximo de previsão necessário.
Diferente de outros métodos de previsões, como classificações e regressões sem a influência do tempo, em séries temporais não podemos dividir os dados de treino e teste com amostras aleatórias de qualquer parte dos dados, deve-se seguir o critério temporal da série, onde os dados de treino devem vir antes dos dados de teste.
# creating train and test sets ------------------------------------------------
GenerateTrainTestDatasets(target_ts,
                          parameters$train_start,
                          parameters$train_end,
                          parameters$test_start,
                          parameters$test_end)

test_sample_size = parameters$test_sample_size

train_ts <- readRDS('../data/processed/train_ts.rds')
test_ts  <- readRDS('../data/processed/test_ts.rds')
A seguir vemos o plot dos datasets de treino e teste.
# plot of the training and testing temporal series
plot(train_ts,
     xlab = "Tempo",
     ylab = "Indices",
     xaxt = "n",
     xlim = c(parameters$start_year, parameters$end_year),
     ylim = c(0, max(train_ts)),
     bty = "l")

axis(1, at = seq(parameters$start_year, parameters$end_year, 1),
     labels = format(seq(parameters$start_year, parameters$end_year, 1)))
lines(test_ts, bty = "l", col = "red")
box(lty = '1373', col = 'black')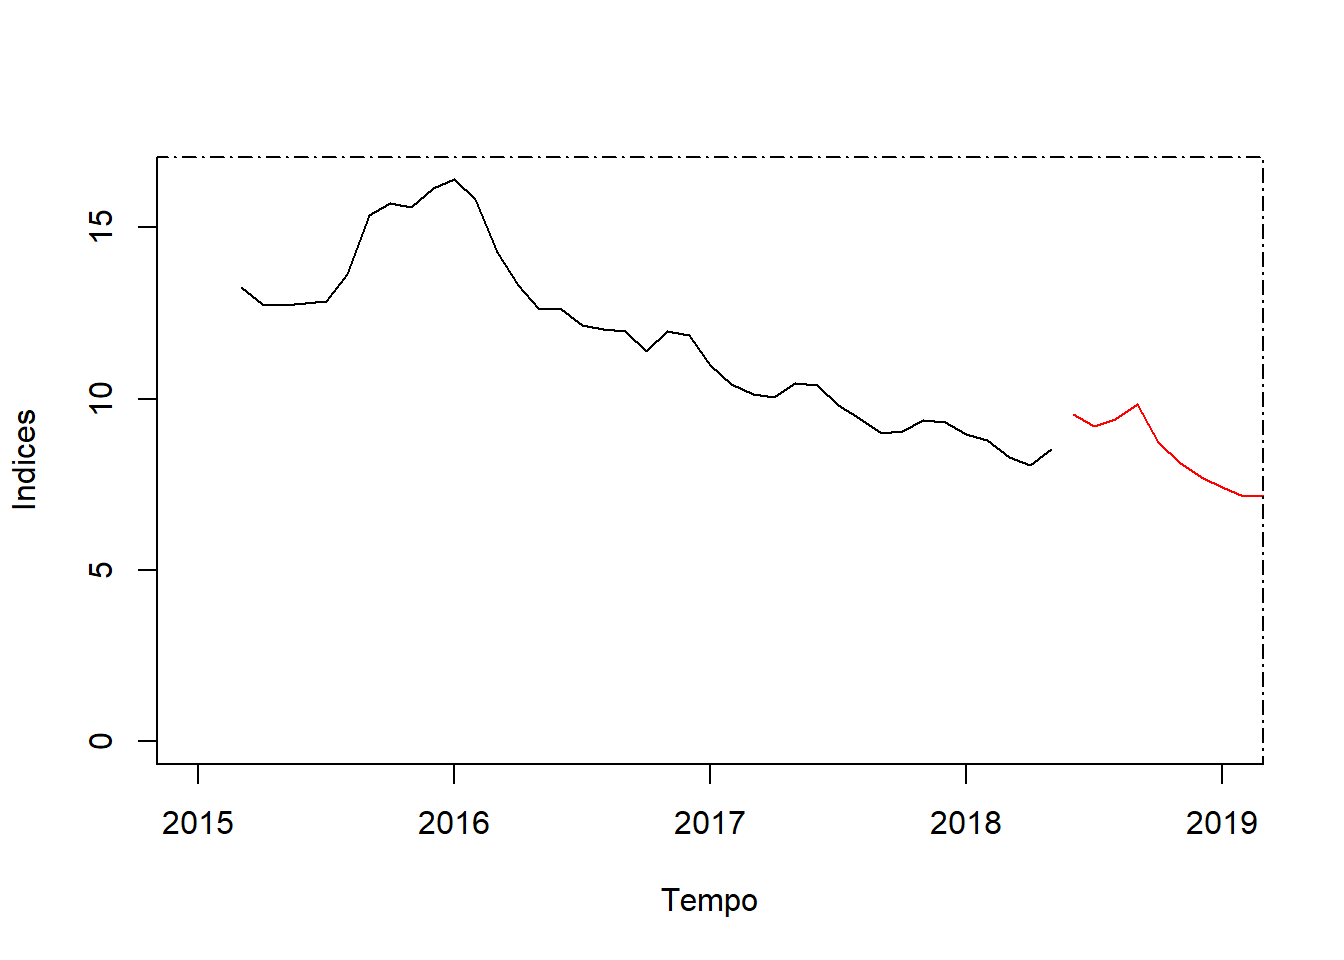
2 Executado os modelos de análise de séries temporais
2.1 Rodando e salvando o modelo Naive de séries temporais
Para executarmos o modelo Naive de séries temporais, utilizamos a função GenerateNaiveTimeSeriesModel criada para rodar este modelo, gravando os resultados no diretório do projeto \models para uso futuro.
Uma vez executada, a função retorna um preview com os resultados de MAPE para o modelo, mostrados a seguir.
| Model | MAPE_Train | MAPE_Test |
|---|---|---|
| ts_naive_model | 3.543476 | 25.18999 |
2.2 Rodando e salvando os modelos lineares de séries temporais
Para executarmos todos os modelos lineares de séries temporais, utilizamos a função GenerateLinearTimeSeriesModels criada para rodar cada um dos modelos desejados, gravando os resultados no diretório do projeto \models para uso futuro.
Uma vez executada, a função retorna um preview com os resultados de MAPE para cada um dos modelos, mostrados a seguir.
| Model | MAPE_Train | MAPE_Test |
|---|---|---|
| ts_linear_model_trend | 6.377961 | 10.02708 |
| ts_linear_model_trend_square | 7.062046 | 51.85623 |
| ts_linear_model_season | 18.002127 | 66.36612 |
| ts_linear_model_trend_season | 7.137634 | 14.34463 |
| ts_linear_model_trend_square_season | 6.635861 | 49.02732 |
2.3 Rodando e salvando o modelo Moving Average (MA) de séries temporais
Para executarmos o modelo Moving Average (MA) de séries temporais, utilizamos a função GenerateMovingAverageTimeSeriesModel criada para rodar este modelo, gravando os resultados no diretório do projeto \models para uso futuro.
ma_consolidation <- GenerateMovingAverageTimeSeriesModel(target_ts,
                                                         train_ts,
                                                         test_ts,
                                                         test_sample_size,
                                                         parameters$start_year,
                                                         parameters$end_year)
Uma vez executada, a função retorna um preview com os resultados de MAPE para o modelo, mostrados a seguir.
| Model | MAPE_Train | MAPE_Test |
|---|---|---|
| ts_moving_average_model | 12.3794 | 29.92407 |
2.4 Rodando e salvando os modelos de suavização exponencial de séries temporais
Para executarmos todos os modelos de suavização exponencial de séries temporais, utilizamos a função GenerateExponentialsmoothingStateTimeSeriesModel criada para rodar cada um dos modelos desejados, gravando os resultados no diretório do projeto \models para uso futuro.
smoothing_consolidation <- GenerateExponentialsmoothingStateTimeSeriesModel(target_ts,
                                                                            train_ts,
                                                                            test_ts,
                                                                            test_sample_size)
Uma vez executada, a função retorna um preview com os resultados de MAPE para cada um dos modelos, mostrados a seguir.
| Model | MAPE_Train | MAPE_Test |
|---|---|---|
| ts_exponential_smoothing_model_ANN | 3.452853 | 25.189623 |
| ts_exponential_smoothing_model_AAN | 3.290830 | 35.440315 |
| ts_exponential_smoothing_model_ANA | 3.132936 | 30.428342 |
| ts_exponential_smoothing_model_AAA | 3.128303 | 12.294188 |
| ts_exponential_smoothing_model_MNN | 3.457771 | 25.189623 |
| ts_exponential_smoothing_model_MAN | 3.238995 | 34.959426 |
| ts_exponential_smoothing_model_MMN | 3.262919 | 26.787589 |
| ts_exponential_smoothing_model_MNM | 6.277865 | 27.739553 |
| ts_exponential_smoothing_model_MAM | 2.997105 | 8.958037 |
| ts_exponential_smoothing_model_MMM | 2.993363 | 24.220235 |
| ts_exponential_smoothing_model_MNA | 2.929558 | 27.474490 |
| ts_exponential_smoothing_model_MAA | 3.156637 | 15.608693 |
| ts_exponential_smoothing_model_ZZZ | 3.457771 | 25.189623 |
3 Avaliando os modelos utilizados e seus resultados
Para análise inicial dos modelos será utilizado como base a métrica MAPE (Mean Absolute Percentage Error, ou Erro Percentual Médio Absoluto).
Essa métrica é interessante de ser usada, geralmente em relatórios gerenciais, pois o erro é medido em termos percentuais e pode-se comparar o erro percentual do modelo de um produto X com o erro percentual de um produto Y.
O cálculo dessa métrica pega o valor absoluto do erro dividido pelo preço real e posteriormente é calculada a média:
\[MAPE = \frac{1}{n} \sum_{d_i} (\frac{1}{q} \sum_{t_j}\left\lvert{\frac{gap_{i,j}-s_{i,j}}{gap_{i,j}}}\right\rvert)\]
Para analisar o desempenho dos modelos utilizados em nosso dataset de série temporal, vamos primeiramente classificar do melhor para o pior, baseado no resultado de MAPE na base de teste.
mape_ranking <- rbind(naive_consolidation,
                      linear_consolidation,
                      ma_consolidation,
                      smoothing_consolidation) %>%
        arrange(MAPE_Test) %>%
        mutate(Rank_ID = row_number())

mape_ranking <- mape_ranking[c(4,1,2,3)]

kable(mape_ranking)| Rank_ID | Model | MAPE_Train | MAPE_Test |
|---|---|---|---|
| 1 | ts_exponential_smoothing_model_MAM | 2.997105 | 8.958037 |
| 2 | ts_linear_model_trend | 6.377961 | 10.027077 |
| 3 | ts_exponential_smoothing_model_AAA | 3.128303 | 12.294188 |
| 4 | ts_linear_model_trend_season | 7.137634 | 14.344627 |
| 5 | ts_exponential_smoothing_model_MAA | 3.156637 | 15.608693 |
| 6 | ts_exponential_smoothing_model_MMM | 2.993363 | 24.220235 |
| 7 | ts_exponential_smoothing_model_ANN | 3.452853 | 25.189623 |
| 8 | ts_exponential_smoothing_model_MNN | 3.457771 | 25.189623 |
| 9 | ts_exponential_smoothing_model_ZZZ | 3.457771 | 25.189623 |
| 10 | ts_naive_model | 3.543476 | 25.189991 |
| 11 | ts_exponential_smoothing_model_MMN | 3.262919 | 26.787589 |
| 12 | ts_exponential_smoothing_model_MNA | 2.929558 | 27.474490 |
| 13 | ts_exponential_smoothing_model_MNM | 6.277865 | 27.739553 |
| 14 | ts_moving_average_model | 12.379401 | 29.924069 |
| 15 | ts_exponential_smoothing_model_ANA | 3.132936 | 30.428342 |
| 16 | ts_exponential_smoothing_model_MAN | 3.238995 | 34.959426 |
| 17 | ts_exponential_smoothing_model_AAN | 3.290830 | 35.440315 |
| 18 | ts_linear_model_trend_square_season | 6.635861 | 49.027322 |
| 19 | ts_linear_model_trend_square | 7.062046 | 51.856233 |
| 20 | ts_linear_model_season | 18.002127 | 66.366120 |
O modelo ts_exponential_smoothing_model_MAM demonstrou a melhor métrica de MAPE, com o valor de 8.9580367.
Para analisarmos com mais detalhes o modelo com melhor performance, vamos carregar o objeto salvo anteriormente com todos os resultados do modelo.
3.1 Checando a aderencia do melhor modelo na base de validação
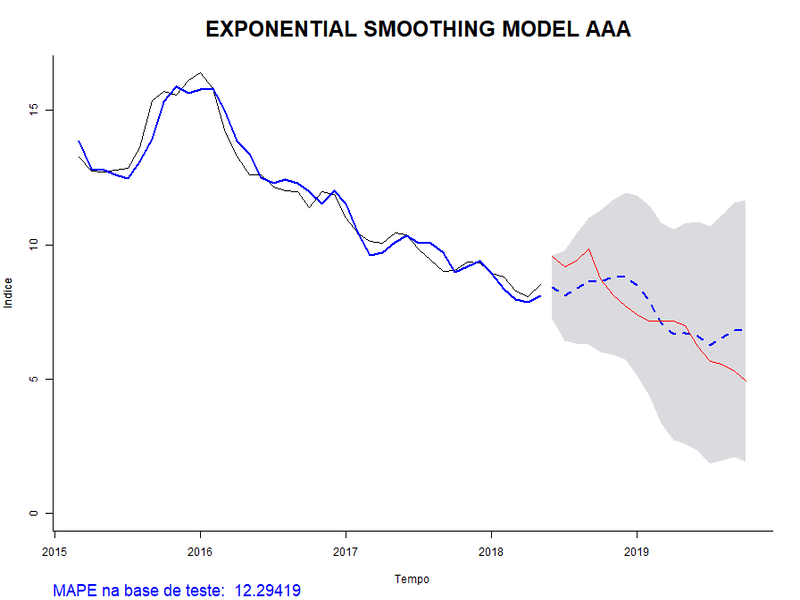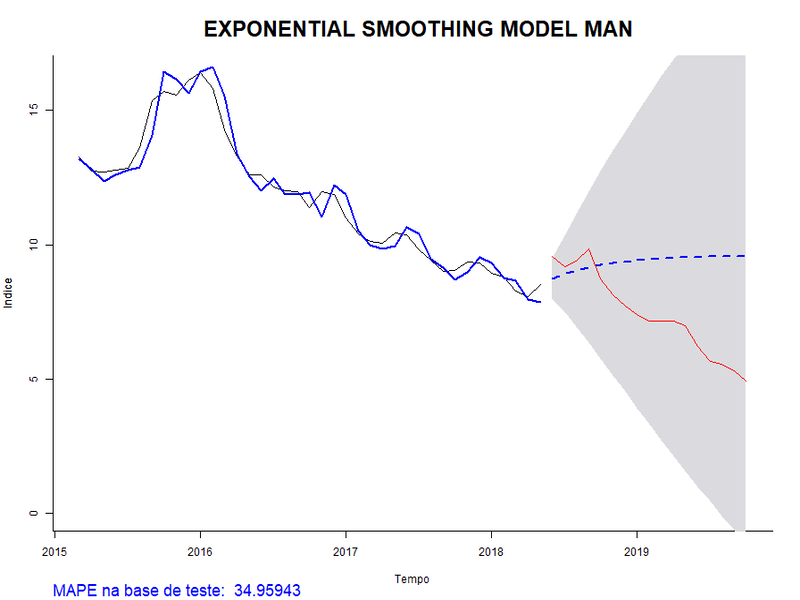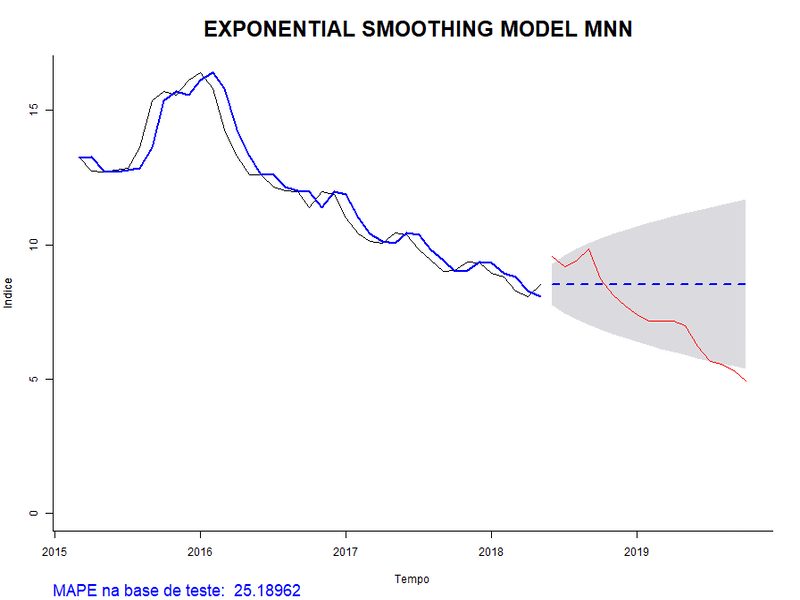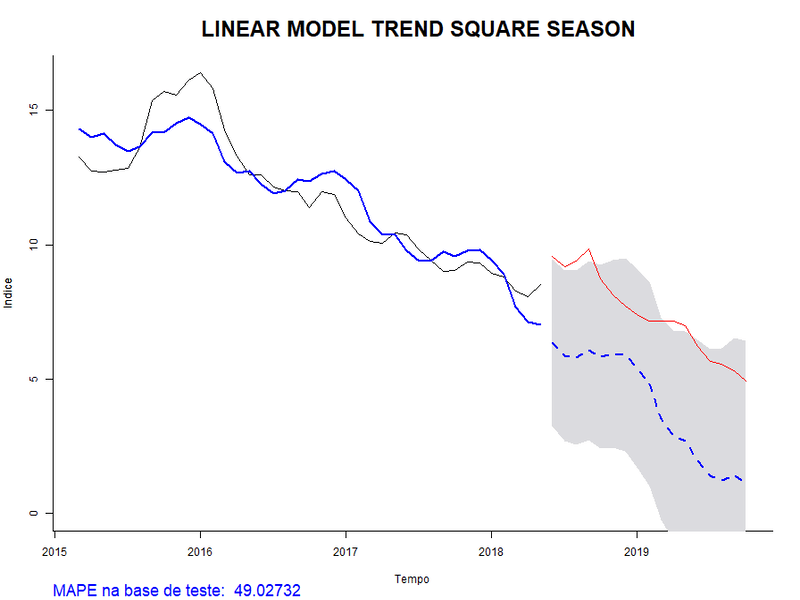
Animação do fit de na base de testes de todos os modelos lineares e exponenciais calculados.
3.2 Resultados gerais do modelo com a melhor métrica MAPE
## ETS(M,A,M)
##
## Call:
##  ets(y = train_ts, model = method)
##
##   Smoothing parameters:
##     alpha = 0.9442
##     beta  = 4e-04
##     gamma = 0.0039
##
##   Initial states:
##     l = 14.7695
##     b = -0.164
##     s = 1.0047 1.0211 1.0476 1.0338 1.0169 1.0271
##            0.981 0.9767 0.9929 0.9819 0.9526 0.9637
##
##   sigma:  0.0496
##
##      AIC     AICc      BIC
## 112.4614 141.6042 140.7419
##
## Training set error measures:
##                      ME     RMSE       MAE         MPE     MAPE      MASE
## Training set 0.01167671 0.486805 0.3682654 0.001297779 2.997105 0.1479532
##                   ACF1
## Training set 0.4978577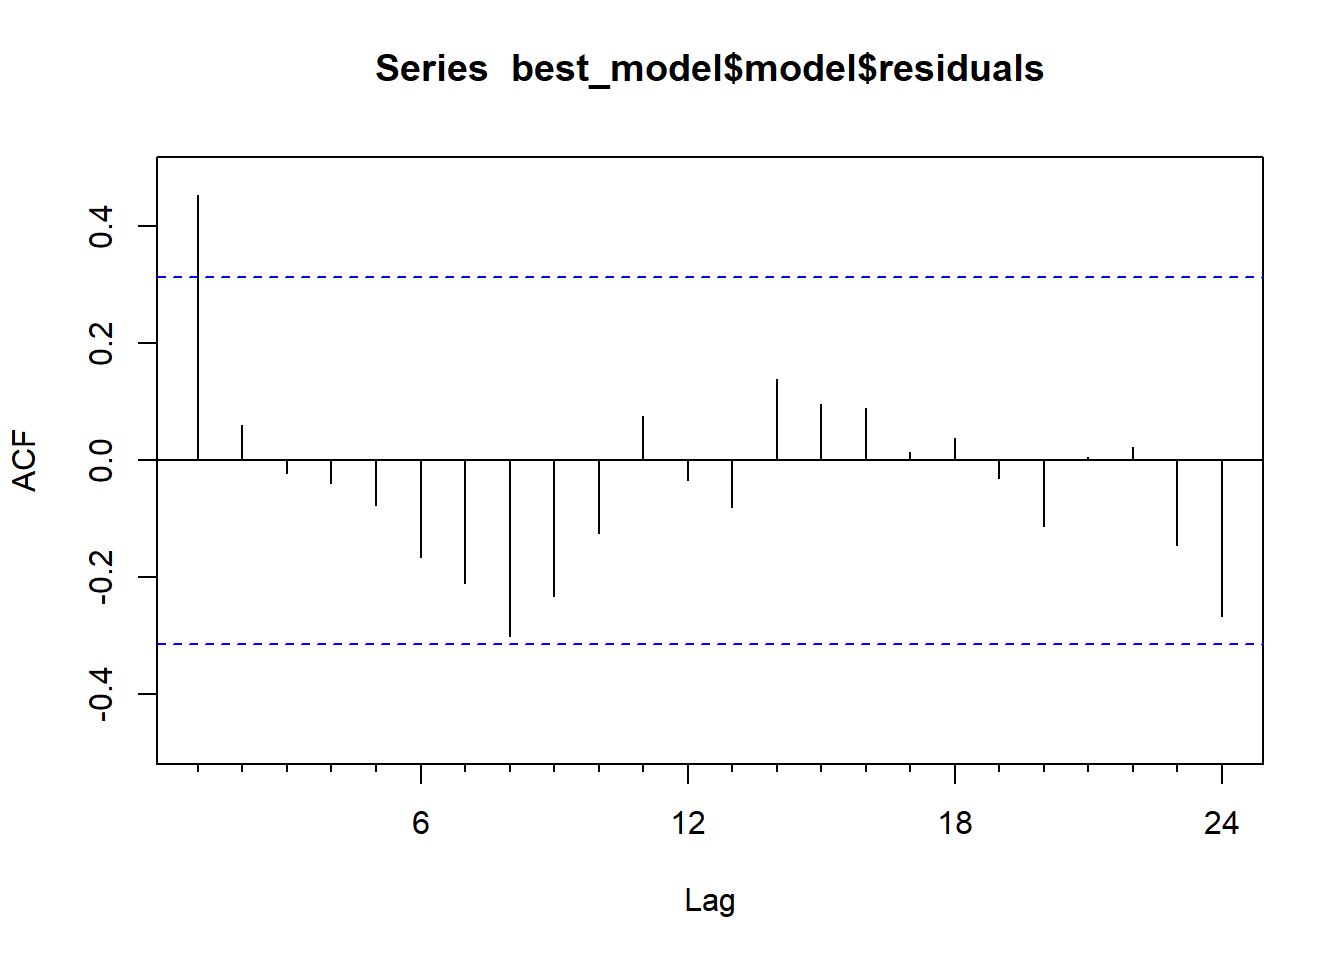
3.2.2 Checando resíduos do modelo
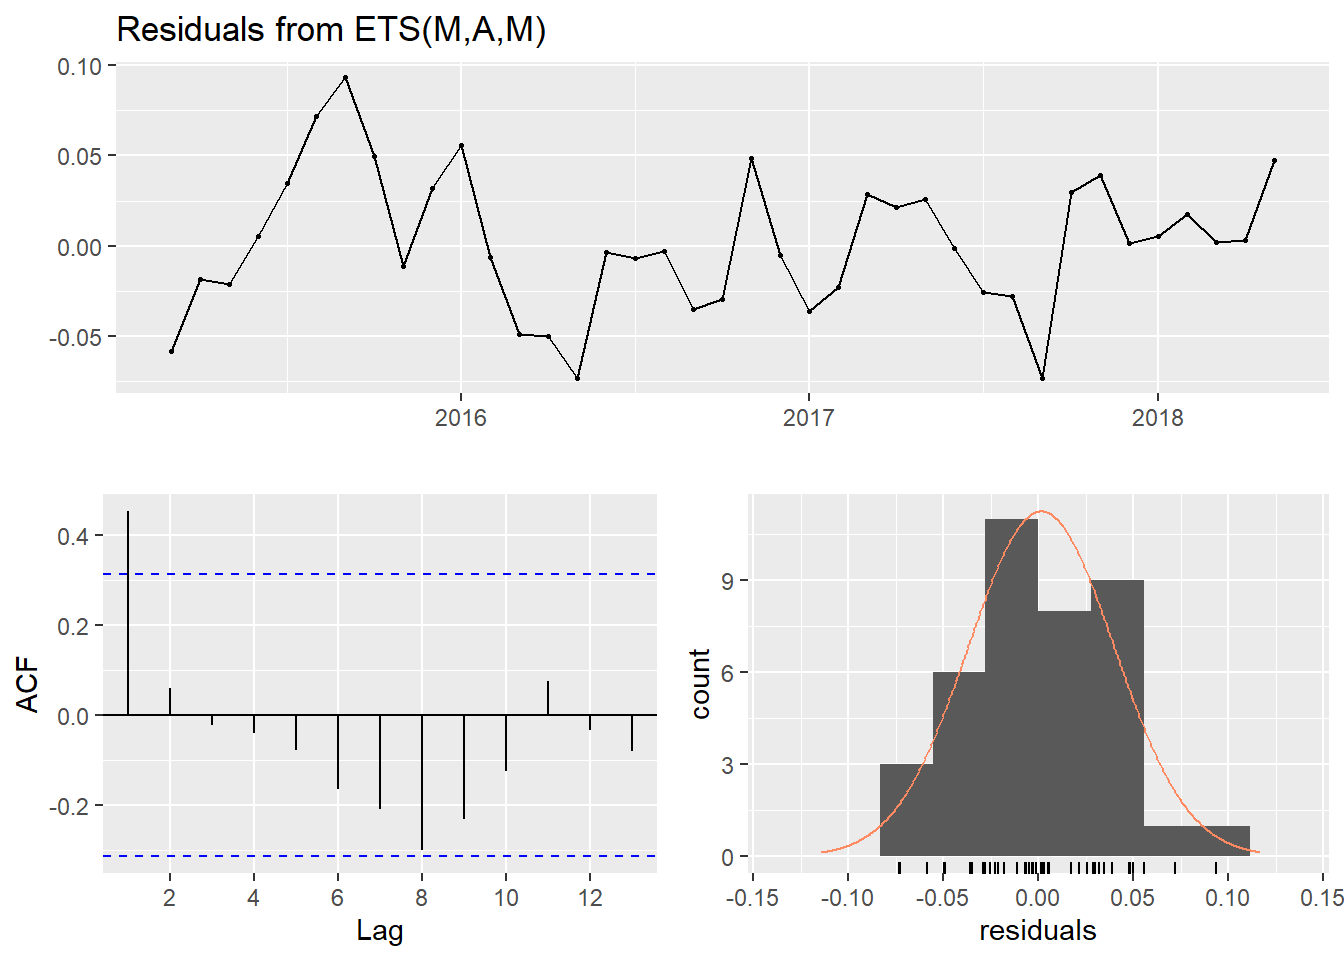
##
##  Ljung-Box test
##
## data:  Residuals from ETS(M,A,M)
## Q* = 24.457, df = 3, p-value = 2.005e-05
##
## Model df: 16.   Total lags used: 19
3.2.3 Checando a projeção do modelo
##
## Forecast method: ETS(M,A,M)
##
## Model Information:
## ETS(M,A,M)
##
## Call:
##  ets(y = train_ts, model = method)
##
##   Smoothing parameters:
##     alpha = 0.9442
##     beta  = 4e-04
##     gamma = 0.0039
##
##   Initial states:
##     l = 14.7695
##     b = -0.164
##     s = 1.0047 1.0211 1.0476 1.0338 1.0169 1.0271
##            0.981 0.9767 0.9929 0.9819 0.9526 0.9637
##
##   sigma:  0.0496
##
##      AIC     AICc      BIC
## 112.4614 141.6042 140.7419
##
## Error measures:
##                      ME     RMSE       MAE         MPE     MAPE      MASE
## Training set 0.01167671 0.486805 0.3682654 0.001297779 2.997105 0.1479532
##                   ACF1
## Training set 0.4978577
##
## Forecasts:
##          Point Forecast    Lo 95    Hi 95
## Jun 2018       8.442854 7.622432 9.263276
## Jul 2018       8.144859 7.045331 9.244388
## Aug 2018       8.021042 6.693408 9.348675
## Sep 2018       8.228316 6.645732 9.810900
## Oct 2018       7.981957 6.250634 9.713279
## Nov 2018       7.946001 6.038928 9.853074
## Dec 2018       7.878624 5.813585 9.943662
## Jan 2019       7.511565 5.381797 9.641333
## Feb 2019       7.225532 5.025261 9.425804
## Mar 2019       6.771317 4.569070 8.973564
## Apr 2019       6.538113 4.277011 8.799214
## May 2019       6.578786 4.168021 8.989552
## Jun 2019       6.490090 3.976486 9.003694
## Jul 2019       6.223993 3.683051 8.764935
## Aug 2019       6.091451 3.475036 8.707865
## Sep 2019       6.208364 3.407065 9.009663
## Oct 2019       5.981558 3.149769 8.813346
3.2.4 Checando a aderência do melhor modelo na base de validação
plot(best_model$model_projected,
     bty = "l",
     ylim = c(0, max(best_model$model_final_projected$fitted) * 1.1),
     flty = 2,
     ylab = 'Indice',
     main = str_to_upper(str_replace_all(best_model$title,'ts|_',' ')))

title(sub = paste('MAPE na base de teste: ', round(filter(mape_ranking, Model == best_model$title)$MAPE_Test, 5)),
      col.sub = 'blue',
      cex.sub = 1.5,
      adj = 0.5)

lines(best_model$model_projected$fitted, lwd=2, col = "blue")
lines(test_ts, col = 'red')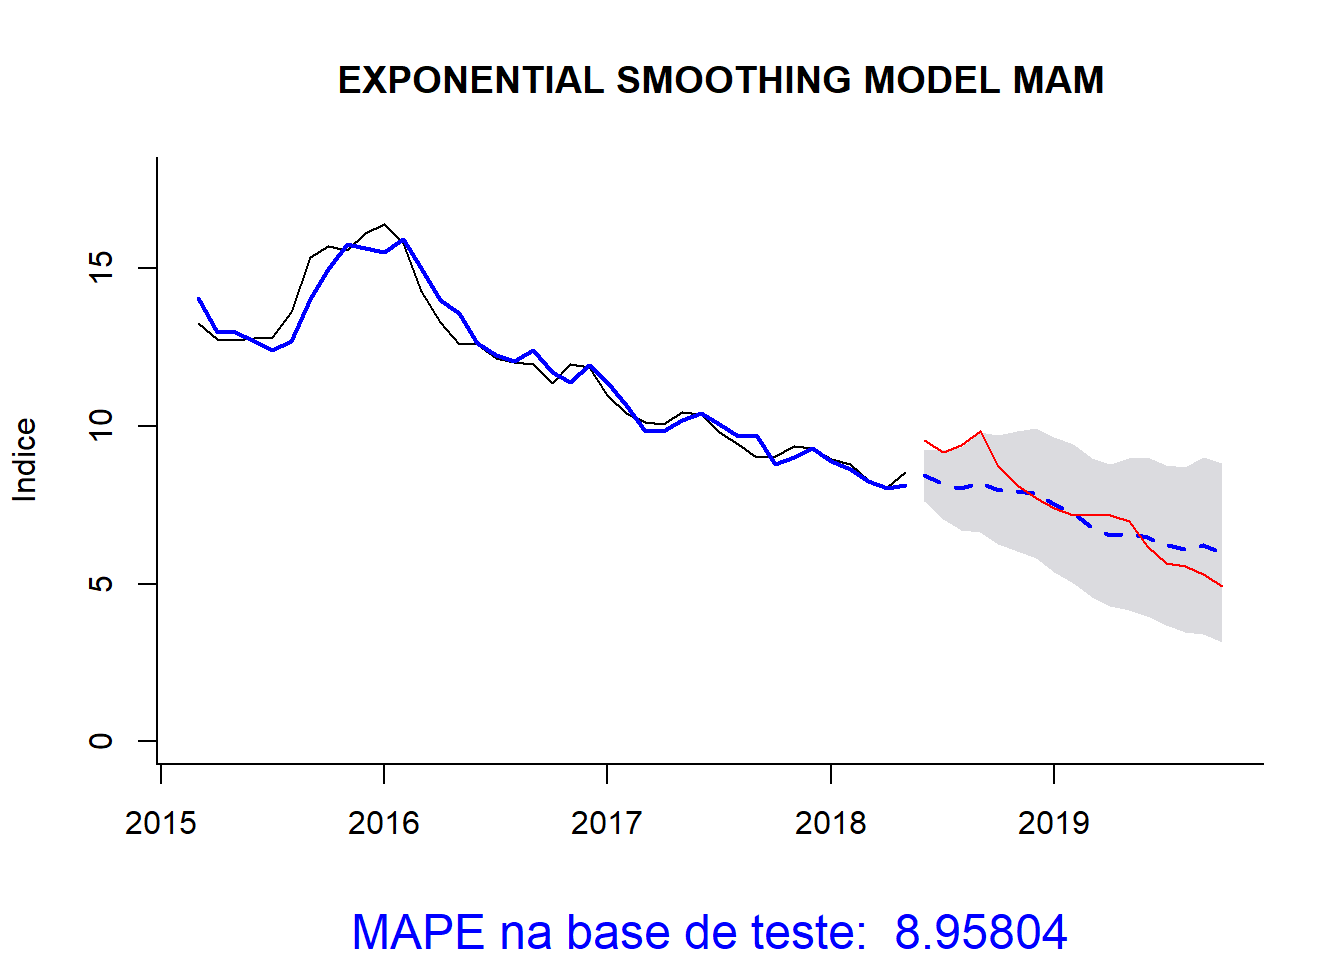
3.2.5 Checando as métricas do modelo
##                      ME      RMSE       MAE         MPE     MAPE      MASE
## Training set 0.01167671 0.4868050 0.3682654 0.001297779 2.997105 0.1479532
## Test set     0.22663207 0.7975745 0.6593151 1.067556556 8.958037 0.2648845
##                   ACF1 Theil's U
## Training set 0.4978577        NA
## Test set     0.7576739  1.749004
3.2.6 Checando a projeção final do modelo
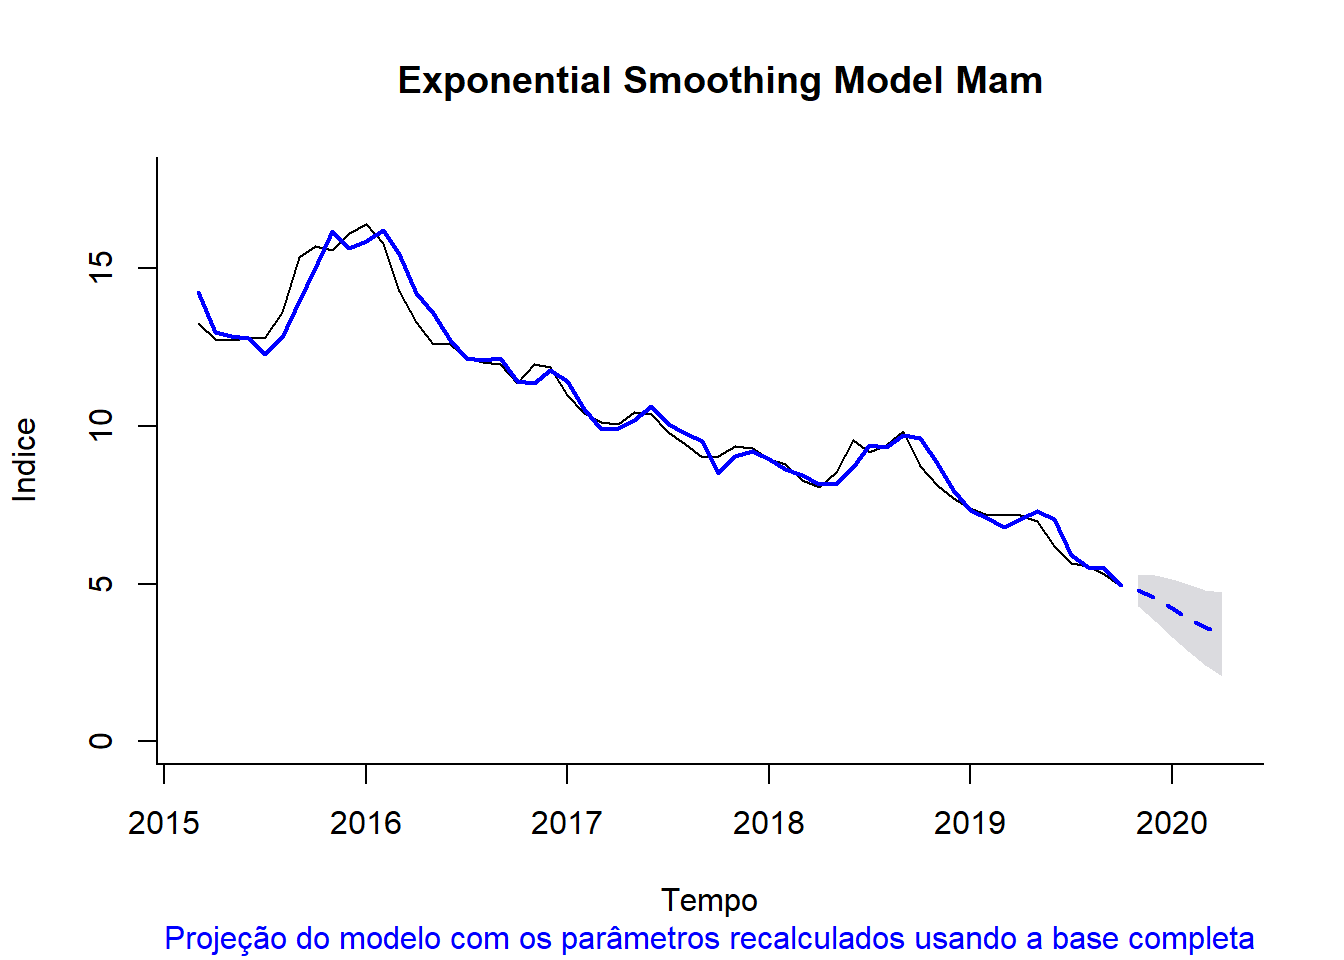
plot(best_model$model_final_projected,
     bty = "l",
     ylim = c(0, max(best_model$model_final_projected$fitted) * 1.1),
     flty = 2,
     main = str_to_title(str_replace_all(best_model$title,'ts|_',' ')))

title(sub = 'Projeção do modelo com os parâmetros recalculados usando a base completa', col.sub = 'blue',
      xlab = "Tempo",
      ylab = "Indice")

lines(best_model$model_final_projected$fitted, lwd=2, col="blue")